GPT-6 솔 및 루나 모델 개요
오픈AI가 GPT-6 아스트라에 이어 코딩과 추론에 특화된 ‘솔(Sol)’과 비용 효율성을 강조한 ‘루나(Luna)’를 추가로 출시했습니다.
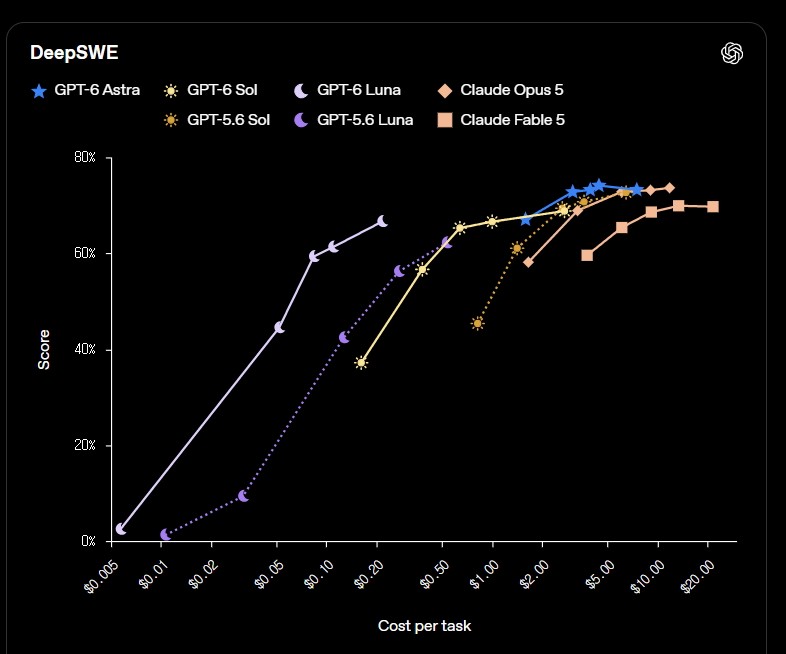
이는 최고 성능이 필요한 작업은 아스트라에 맡기고, 일상적인 전문 업무나 개발 작업에서는 속도와 비용 효율을 높인 솔과 루나를 선택하도록 제품군을 세분화한 전략입니다.
솔은 복잡한 코딩, 추론, 에이전트 업무에 최적화되어 있으며, 루나는 요약이나 정보 추출과 같이 대량의 반복적 단순 작업에서 속도와 비용 효율을 중시합니다.
두 모델 모두 이전 세대 대비 업무 수행 능력, 사실 정확성, 코딩 및 컴퓨터 사용 능력이 향상되었습니다. 특히 API 가격은 기존 프로모션 가격 대비 절반 수준으로 낮춰 접근성을 높였습니다.
성능 향상 및 오류율 감소
오픈AI는 GPT-6 솔(Sol) 모델의 사실 오류율이 전작 GPT-5.6 솔 대비 약 절반 수준으로 감소했다고 밝혔습니다.
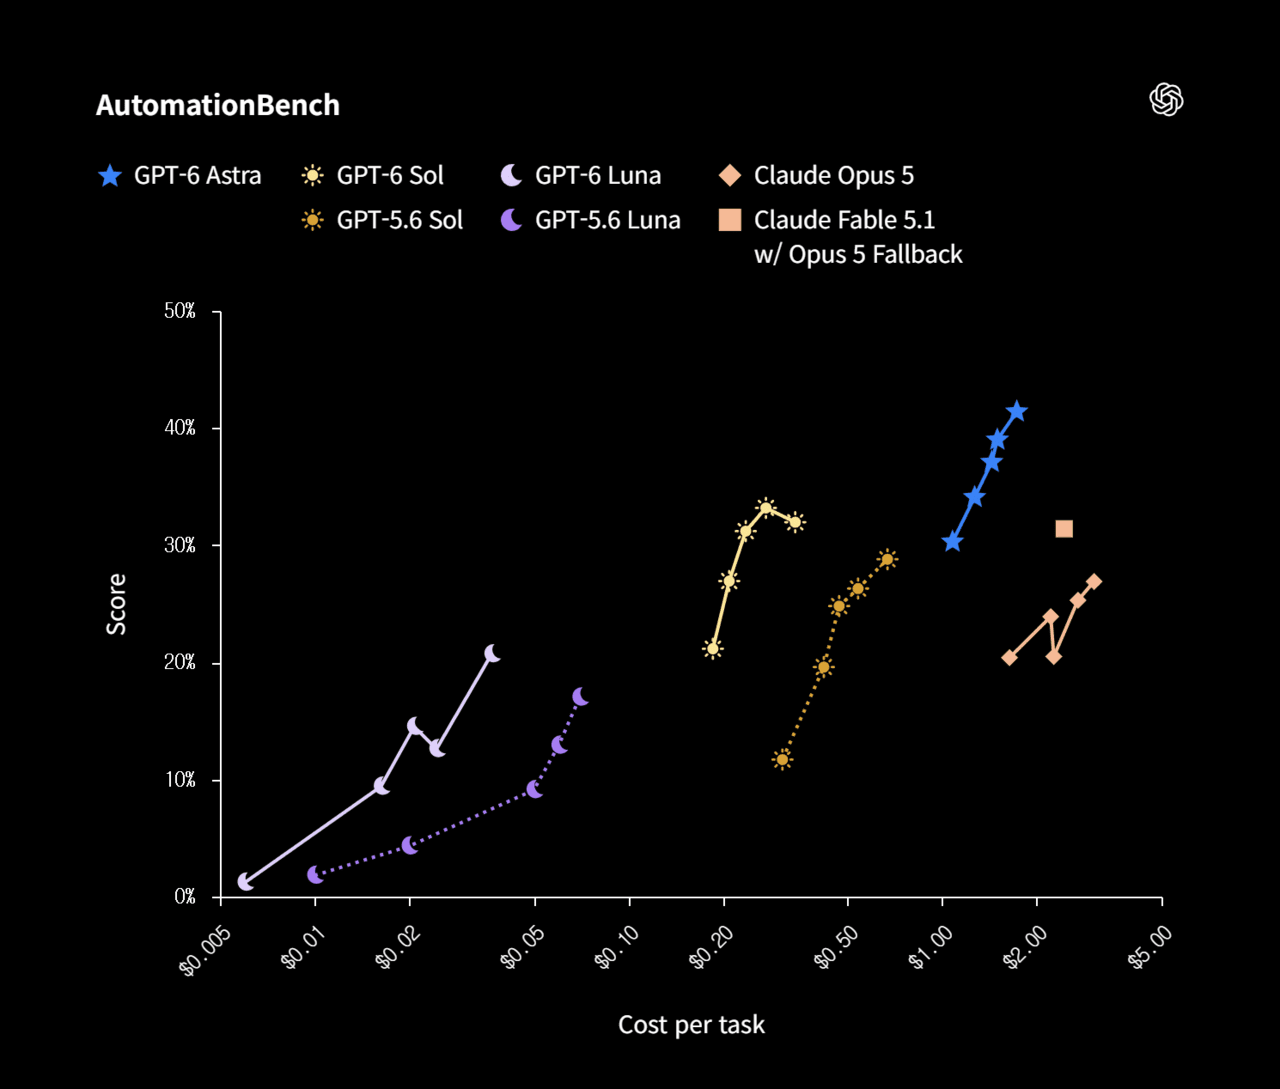
이는 이용자들이 기존 모델의 오류를 지적한 비식별화된 실제 챗GPT 대화를 대상으로 평가한 결과로, 더 적은 비용으로 GPT-6 아스트라에 근접한 정확성을 보여준다는 설명입니다.
코딩 작업에서의 ‘기만적 답변’ 비율도 크게 개선되었습니다. GPT-6 솔은 1.3%, 루나는 2.8%를 기록해 각각 GPT-5.6 솔(10.4%), 루나(9.5%)보다 낮았습니다.
GPT-6 루나는 높은 추론 수준에서 GPT-5.6 솔과 비슷한 정확성을 내면서도 비용은 약 100분의 1 수준에 그쳤습니다.
다만 이 평가는 오류가 발생하기 쉬운 대화를 선별해 진행한 것이므로, 일반적인 챗GPT 사용 환경에서의 오류율을 그대로 의미하지는 않습니다.
API 가격 인하 및 캐싱 효율
GPT-6 솔(Sol)과 루나(Luna) 모델은 캐싱 및 추론 효율을 대폭 개선하여 API 가격을 기존 대비 50% 인하했습니다.
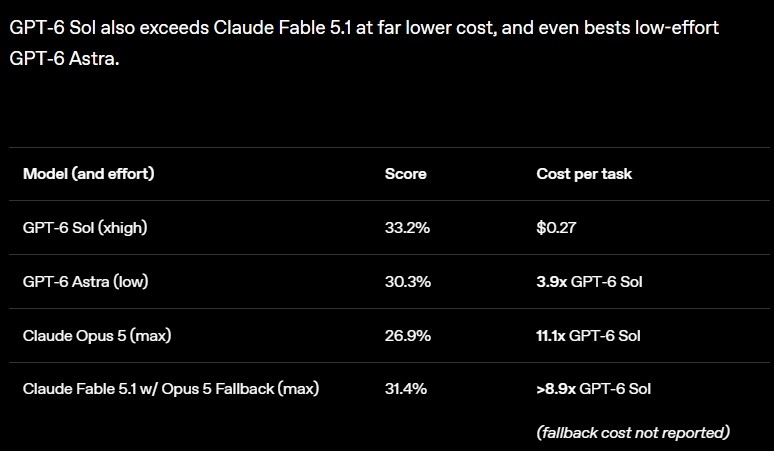
특히 반복적으로 사용되는 입력 문맥을 재처리하지 않고 재사용하는 ‘프롬프트 캐싱’의 기본 적중률을 높여, 캐시된 입력 토큰에는 일반 입력보다 90% 저렴한 가격 정책을 적용했습니다.
이러한 효율화 조치로 깃허브는 최근 수개월간 새롭게 처리해야 하는 프롬프트 토큰 비중이 50% 이상 줄었다고 밝혔습니다.
구체적인 100만 토큰당 단가는 솔 모델이 입력 2달러, 출력 10달러이며, 루나 모델은 입력 0.1달러, 출력 0.5달러로 책정되어 개발 비용 절감 효과를 극대화했습니다.